001
Cosmo, un orquestador que no cree a los agentes
El experimento consiste en medir si, al obligar a cada tarea a pasar por un build, una suite de pruebas y una revisión adversarial antes de hacer merge, la cola puede trabajar sola de noche sin que los bloqueos y las intervenciones manuales se coman el tiempo que debería ahorrar.
- Estado
- Activo
- Inicio
- 2026-08-26
- Última entrada
- 2026-09-09
- Stack
- Agentes · Python · OpenSpec · Playwright · Docker · SQLite
Hipótesis
Si se obliga a cada tarea a pasar por un build real, una suite de pruebas real y una revisión adversarial real antes de tocar la rama de integración, la cola debería poder trabajar sola durante la noche sin que el costo de vigilarla (bloqueos, intervenciones manuales, gasto) crezca más rápido que el tiempo que ahorra.
Esto es un experimento y no una opinión porque “el costo de vigilarla” se puede contar: cuántas tareas de un lote real terminan solas, cuántas necesitan que un humano decida algo a mano, y cuánto cuesta en dólares una corrida completa. Nada de eso se sabía de entrada. Se sabe ahora porque quedó registrado en la misma base sqlite que Cosmo usa para llevar su propia cola, no en la memoria de quien la corrió.
Método
Dos lotes de prueba hasta ahora, ejecutados en momentos distintos, contra objetivos de dificultad muy distinta a propósito.
Lote A — aislar a Cosmo de la complejidad del stack. De seis specs muy limitadas planeadas, tres llegaron a ejecutarse: lista de tareas, gestor de hábitos y timer pomodoro, sobre la misma plantilla Vite+React sin backend ni base de datos, 24 tareas en total repartidas en tres proyectos independientes. La idea explícita era que un fallo solo pudiera atribuirse a la cola misma (manejo de dependencias, reintentos, guardrails), nunca a que el stack de turno fuera complejo o el causante de los errores.
Lote B — un DAG real. Un DAG (un grafo de dependencias entre tareas, donde cada una puede necesitar
que otra termine antes, nunca al revés) de 24 tareas encadenadas contra wa-chat-component, un componente
de chat de verdad (solo frontend), con dependencias reales entre tareas (no se puede construir la burbuja
de mensaje antes que el modelo de datos) y verificación visual real (Storybook, pruebas de regresión
visual con Playwright). Acá el objetivo era estresarlo, no aislarlo.
Para ambos lotes la medición no sale de leer la transcripción de lo que el agente dijo que hizo. Sale de consultar directamente las tablas que Cosmo ya lleva para sí mismo (cola de tareas, fallos, transiciones de estado, costo por sesión) y clasificar desde ahí.
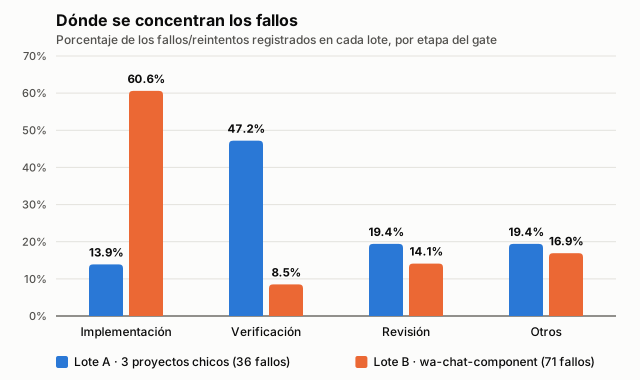
En el lote A los fallos se concentran en verificación: build, e2e y revisión adversarial atrapan dos de
cada tres de los 36 registrados, señal de que la mayoría de las tareas se completaban y tropezaban recién
al chequearlas. En el lote B el patrón se invierte: el 61% de los 71 fallos ocurre en plena
implementación, antes de que haya algo que verificar, casi siempre agotamiento de turnos
(error_max_turns, 25 de 71 por sí solo).
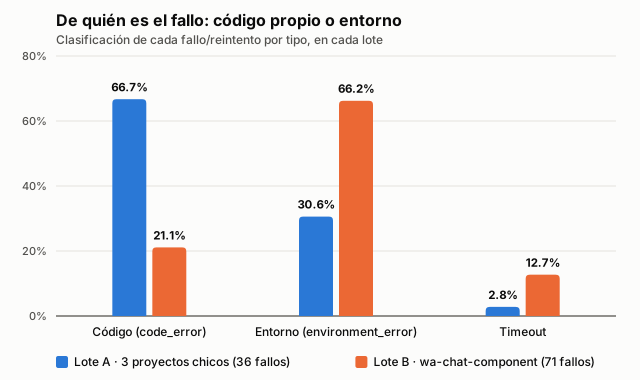
La misma inversión aparece en el tipo de fallo. En el lote A dos de cada tres son code_error: el gate
atrapando código real mal escrito. En el lote B dos de cada tres son environment_error: el harness
quedándose sin turnos, cayendo por timeout o perdiendo la sesión, no el agente escribiendo algo incorrecto.
Sobre los valores en dólares, un descargo necesario: no son gasto real en la mayoría de los casos. Ambos
lotes corrieron sobre todo con el harness nativo claude, cubierto por dos suscripciones Pro de Anthropic
($20/mes cada una, de antes de que Anthropic ajustara los límites de cuota en septiembre); lo que Cosmo
registra ahí es el costo equivalente en tokens, no un cargo adicional. Lo único que sí fue gasto real y
medido, vía OpenRouter con claude-openrouter, fueron unos $10 en total, muy lejos de los $231.40 de la
cifra grande.
En el lote A las 24 tareas llegaron a done solo con reintento automático: cero intervención manual de
estado. scaffold-app sola concentró 16 de los 36 fallos y $19.45 de costo, contra un promedio de $5.27
por tarea, casi todos por un npm ci sin lockfile todavía generado. En el lote B las 24 tareas también
llegaron a done, pero solo 21 solas: las otras 3 necesitaron que un humano viera el bloqueo, confirmara
que el trabajo ya hecho era bueno, y saltara manualmente a una etapa posterior, siete intervenciones en
total, cada una con una causa real y distinta (una prop sin default, un checkout base con un archivo
suelto, una revisión que corrió Playwright entero a mano y se quedó sin tiempo). Nunca fue algo que
indique que “el agente se confundió”.
Esos motivos, clasificados, se volvieron nueve arreglos concretos para la versión 0.2.0: un presupuesto de turnos que crece con el progreso real, una revisión que por defecto solo lee el diff, una lista de excepciones estructurales para editar un test sin debilitarlo, y comandos de CLI para las intervenciones que ya eran un patrón. Los nueve tienen prueba de regresión y pasan, pero ninguno tiene todavía una segunda corrida real que confirme que el 35% de error_max_turns y las 3 intervenciones bajan de verdad. Esa es la métrica que falta.
Este experimento mide el cómo. El por qué de Cosmo está en un agente que trabaja por las noches.
Medición
Bitácora
v0.2.0 publicado de verdad: merge a develop y master, tag y release en GitHub el mismo día. Sigue marcado pre-release (no listo para producción) porque la pregunta de la entrada anterior sigue sin respuesta.
v0.2.0 escrito: changelog, versión bumpeada. Ninguno de los nueve arreglos se ha vuelto a medir todavía contra una corrida real de este tamaño: solo contra su propio test unitario.
Los nueve gaps de la auditoría, implementados: presupuesto de turnos que crece con el progreso real, revisión solo-diff por defecto, una lista de excepciones estructurales para editar un test sin debilitarlo, y banderas de CLI para reanudar sin rehacer trabajo ya bueno. Suite propia: de 671 a 794 pruebas.
Auditoría completa de las 27 sesiones reales contra el DAG de 24 tareas de wa-chat-component, consultando la base sqlite en vez de confiar en la narrativa de sesiones anteriores: 71 fallos/bloqueos, $231.40 de gasto medido, y agotamiento de turnos (error_max_turns) explicando el 35% de esos fallos. Tres de las 24 tareas solo llegaron a done con siete intervenciones manuales.
Otras dos tareas de la misma tanda se rompieron por la misma causa: la plantilla no fijaba la versión de Playwright ni el reportero que escribe el resultado que el gate necesita leer. Un gap de la plantilla, no de una tarea puntual: cualquier proyecto futuro lo iba a repetir.
Primera corrida completa (todo-frontend-app, 6 tareas, todas a done, pero scaffold-app sola por 16 fallos/reintentos y $19.45; un "npm ci" sin lockfile explica 7 de esos). Salieron dos bugs reales de Cosmo, no de la app: "openspec archive" y "cosmo init" dejaban el repo con cambios sin comitear, bloqueando el merge de la siguiente tarea; y una colisión de id de tarea entre dos proyectos, porque la clave era global, no por proyecto.
Nace la plantilla vite-react-local con un plan de seis apps chicas para aislar a Cosmo de la complejidad del stack. Solo tres de esas seis llegan a correrse de verdad: lista de tareas, hábitos y pomodoro, 24 tareas en total, sin backend ni base de datos.
Arranca el proyecto. La apuesta de diseño desde el primer commit: una cola de tareas, cada una en su propio git worktree, y un gate de validación real (build, pruebas, e2e) entre la implementación y el merge. Un reporte de éxito del agente no cuenta como evidencia por sí solo.
Estado actual
En construcción. v0.2.0 es un pre-release, no listo para producción, y el proyecto sigue activo y en desarrollo. Los nueve arreglos post-auditoría tienen prueba unitaria, pero nadie ha vuelto a correr un DAG real de este tamaño para confirmar si el 35% de error_max_turns y las 3 intervenciones manuales de cada 24 tareas realmente bajan. Esa segunda corrida es la siguiente medición, no una impresión.